Остановка при блокере, проверка инструментальных вызовов, память и продолжение работы после сжатия контекста. На этой неделе — способы измерять поведение агента целиком и ограничения, которые теряются за одной итоговой метрикой.
Найдено: 20
Ничего не найдено. Попробуйте другой запрос или сбросьте фильтры.
Исследования
Navyansh Mahla · · Препринт arXiv
ActionRAG: граф пересматривает найденные свидетельства памяти
agents
Согласование сущностей при индексации сочетается с локальным распространением релевантности и добавлением связующих троек при запросе. На восьми детерминированных наборах задач MemoryAgentBench авторы сообщают среднее 55,1 против 49,7 HippoRAG-v2; метод выигрывает по шести наборам с поиском свидетельств, но уступает на MH-DocQA и DetectiveQA.
Метод, ограничения и следующий шаг
Как устроено. Сущности согласуют при построении графа, затем запрос выбирает начальные узлы и тройки. Ограниченный обход перераспределяет релевантность, защищает исходные результаты и добавляет недостающие связи. Генератор gpt-4o-mini получает до 7000 токенов. Сравнение использует опубликованные результаты MemoryAgentBench, а не повторный запуск всех конкурентов.
Основание. Эксперимент авторов; независимое воспроизведение здесь не проводилось.
Ограничение. Baselines переписаны из MAB и не перезапущены; три прогона только ActionRAG. Среднее объединяет разные метрики и наборы задач. В MH-DocQA и DetectiveQA ActionRAG уступает HippoRAG-v2. Цена исключает построение графа, хранение и local embedding; 440,7 мс — сумма отдельно измеренных p99, а не полный wall-clock p99. На росте EventQA p99 достигает 7,664 с и средний score падает на 4,2 пункта.
Для моей работы. Структурная память агента требует качественного entity resolution; одной замены графового обхода недостаточно.
Следующий шаг. Сравнить base retrieval и diffusion на одинаковом reconciled graph, включив indexing cost и полный wall time.
Shen Liu, Ze Zhou, Zhenguo Xu, Shaopu Wang, Yike Gao, Chunlei Wang · · Препринт arXiv
LeafSkill: дешёвый выбор допустимого действия на листьях плана
agents
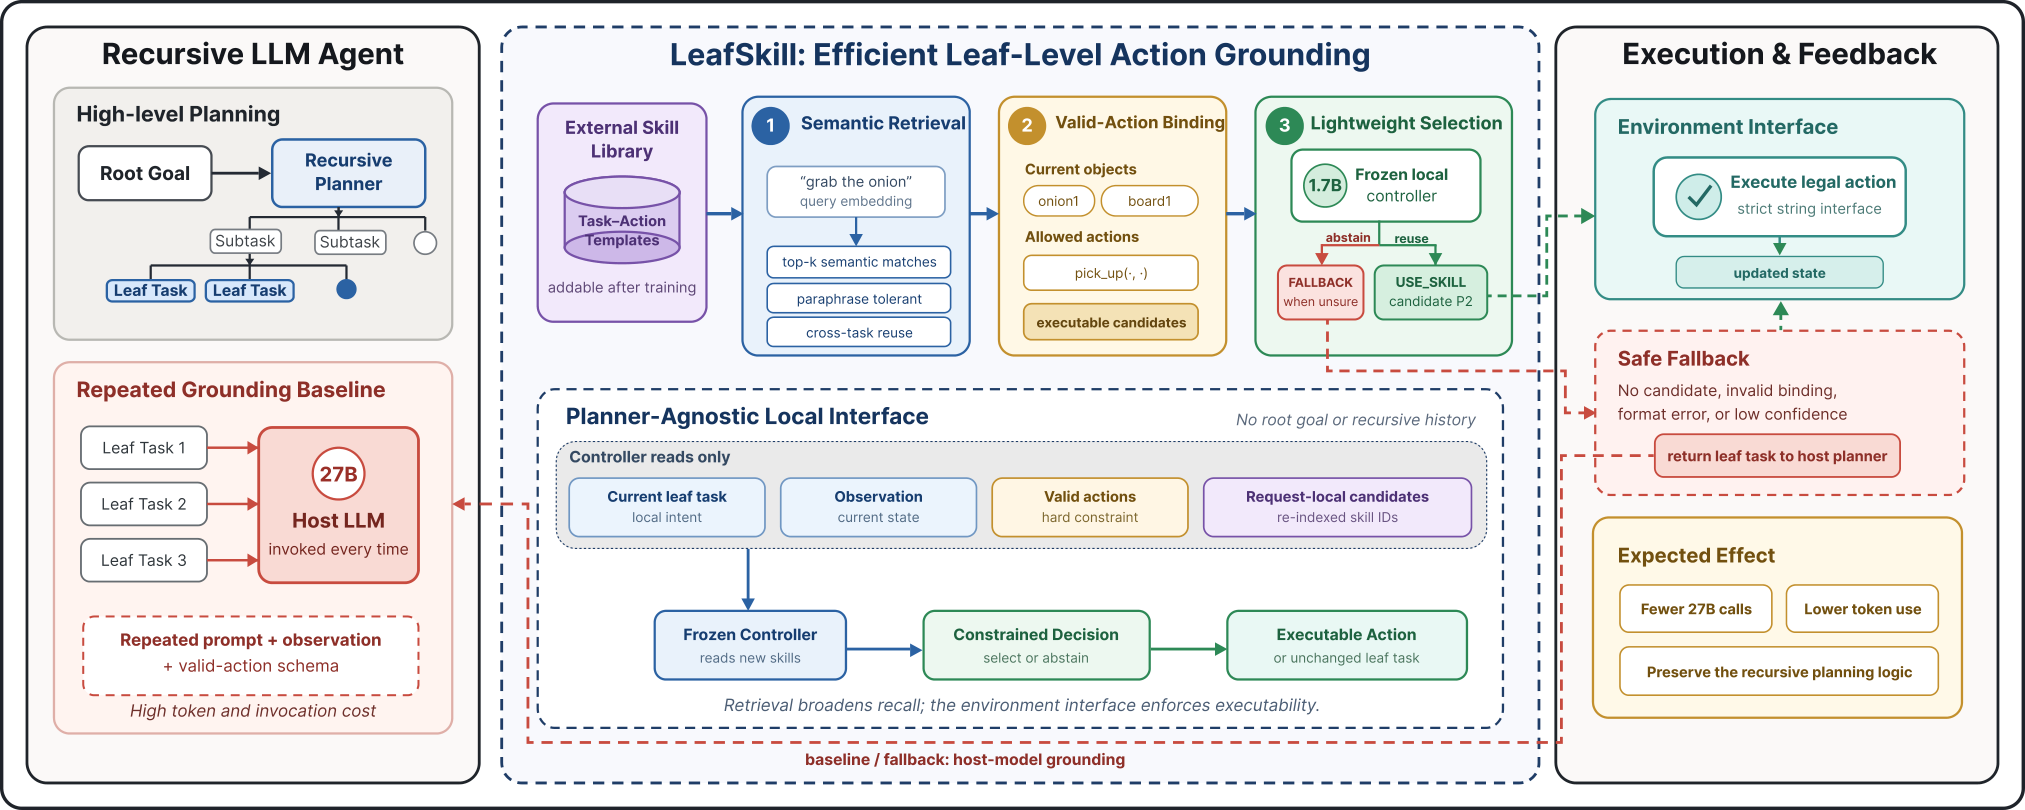
Планировщик ReCAP и основная модель на 27B параметров сохраняют управление задачей, а повторяющиеся конечные действия выбирает селектор на 1,7B. Поиск шаблона и детерминированная привязка ограничивают выбор допустимыми командами; селектор может отказаться. На задачах, решённых обоими режимами, расход токенов основной модели снизился на 23,1% в Robotouille-B, на 41,3% в ALFWorld и на 14,4% в независимом Robotouille-C.
Планировщик передаёт ограниченный набор допустимых действий локальному селектору. ИсточникМетод, ограничения и следующий шаг
Как устроено. Поиск BGE-small возвращает до пяти шаблонов. Детерминированная привязка перечисляет допустимые команды текущего состояния, а дообученный Qwen3-1.7B выбирает идентификатор команды либо отказывается. Основная модель Qwen3.5-27B и планировщик заморожены. Эксперименты: Robotouille и ALFWorld, по три повтора; расход токенов сравнивается только на общих успехах.
Основание. Эксперимент авторов; независимое воспроизведение здесь не проводилось.
Ограничение. Расходы selector приведены отдельно: 6900–9952 токена на эпизод; итоговая стоимость и latency не измерены. Условие jointly solved ограничивает обобщение экономии на весь поток задач. Девять cross-run сравнений переиспользуют три прогона и те же задачи, поэтому не являются девятью независимыми репликациями. Проверены один planner, один host, два симулятора и один selector family. При обходе binder all-negative fallback составляет лишь 7,5%; допустимость команды не доказывает соответствие намерению. Рост библиотеки увеличивает экономию на 88 общих успехах, но success снижается с 137/200 до 131/200.
Для моей работы. Узкая граница делегирования для tool-агентов с whitelist действий; host сохраняет recovery, selector получает ограниченный выбор.
Следующий шаг. Измерить повторяемость leaf-вызовов, построить binder по whitelist; оценить общую стоимость host+selector и OOD intent/abstention.
Michael Dinzinger; Kanishka Ghosh Dastidar; Michael Granitzer · · Препринт arXiv
Decision models не заменили reranker fine-tuning на том же backbone
agents
Авторы сравнили исходные Qwen-модели, их decision fine-tunes и специализированные rerankers на одинаковых BM25 top-100. Для backbones до 9B reranker fine-tuning выиграл 5,2–28,8 пункта nDCG@10; при 27B варианты оказались сопоставимы. Калибровка decision models зависела от формулировки вопроса и не компенсировала слабое ранжирование. Это аргумент проверять ranking, calibration и cutoff отдельно.
Метод, ограничения и следующий шаг
Как устроено. Все варианты получают одинаковые первые 100 документов BM25. Сравнение охватывает исходные Qwen, их модели решений и специализированные переранжировщики. Авторы отдельно оценивают порядок документов, калибровку уверенности и порог отсечения; доступные модели обучались на разных данных и разными способами.
Основание. Эксперимент авторов; независимое воспроизведение здесь не проводилось.
Ограничение. Это сравнение доступных fine-tunes, а не изолированный тест RLCD: различаются данные, loss, исходные checkpoints и способ обучения. Собственные 9B/27B-rerankers обучены по одному разу. Калибровка проверена только на judged TREC DL pairs, grade≥2; fixed cutoff 0,5 считает unjudged нерелевантными. Испытаны два разных определения relevance; 27B tie не подтверждён тестом эквивалентности. Числа не переносимы автоматически на dense/hybrid retrieval, другие языки и production base rate.
Для моей работы. Прямая применимость к RAG: одинаковый backbone и кандидаты снимают распространённую путаницу между качеством исходной модели и пользой decision tuning. Ранжирование и пригодность вероятности для фильтрации требуют отдельных измерений, а калибровку нельзя переносить между base rates без проверки.
Следующий шаг. На своих кандидатах сравнить специализированный reranker и decision model одинакового размера, отдельно измерить nDCG, качество набора после cutoff и калибровку на целевом base rate; включить абляцию wording и сохранить raw scores.
Короткая декларативная спецификация не гарантирует дешёвую генерацию
agents
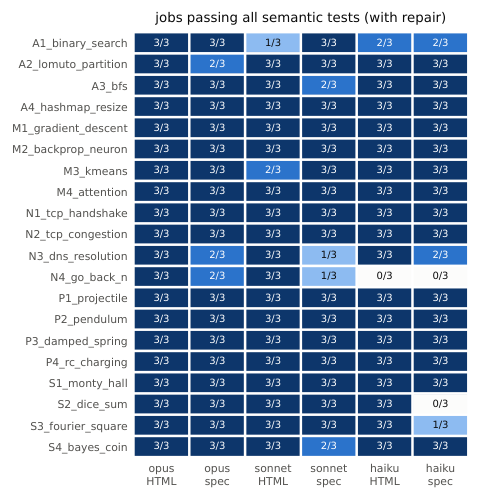
На 20 задачах интерактивных объяснений автор сравнил свободный HTML/JS и свой ExplainSpec при общем контракте наблюдения. В 600 jobs с четырьмя моделями спецификации сокращали answer tokens на 25–48%, но при включённом reasoning ни одна модель не генерировала статистически значимо быстрее. У Claude экономию съедало дополнительное рассуждение; у Qwen reasoning и без того доминировал. Надёжность нового DSL также не выросла, особенно у Qwen3-14B.
Матрица прохождения задач: эквивалентность форматов зависит от модели и задачи. ИсточникМетод, ограничения и следующий шаг
Как устроено. Одинаковые 20 задач описаны свободным HTML/JS и новым декларативным ExplainSpec. Для четырёх моделей собраны 600 запусков с общим контрактом наблюдения. Измеряются корректность, выходные токены, токены рассуждения и время генерации. Это проверка конкретного формата, а не всех языков спецификаций.
Основание. Эксперимент авторов; независимое воспроизведение здесь не проводилось.
Ограничение. Исследован один созданный автором DSL, изучаемый только из промпта, против привычного HTML/JS с адаптируемыми примерами контролов; matched runtime-library baseline отсутствует. 20 авторских задач, три повтора, две семьи моделей не устанавливают универсальный эффект формата. Отсутствие значимого ускорения не доказывает отсутствие ускорения: например, Opus latency ratio 0,90 с CI [0,80;1,01]. Проверки читают exposed state, не проверяют соответствие рисунка и UI и не измеряют педагогический результат. У Qwen большинство спецификаций невалидны, так что экономия токенов не сравнивается при равном качестве. Сдвиг reasoning у Claude exploratory и не повторился в confirmatory Qwen-тесте; без reasoning Qwen действительно ускорился.
Для моей работы. Полезно для выбора формата ответов, UI DSL и агентских артефактов: считать полный output с reasoning, время до рабочего результата и repair cost, а не только размер JSON. Нельзя превращать результат в общий запрет декларативных UI: безопасность runtime, streaming и обучение DSL здесь не проверены.
Следующий шаг. В собственном генераторе сравнить полную стоимость и latency с repairs при одинаковой семантической задаче; добавить familiar DSL или обученные модели, provided-runtime HTML baseline и визуальную оценку. Ошибки runtime должны доходить до repair loop.
Xiaoyu Shi (Aalto University); Wenqiang Luo (City University of Hong Kong); Boyang Yang (Yanshan University); Haoye Tian (Aalto University) · · Препринт arXiv
BlindSpotEval: какие ошибки скрывает высокий coverage у LLM-тестов
agents
BlindSpotEval оценивает тесты по конкретным обязательствам Arrange–Act–Assert: входным границам, ветвям поведения и силе проверок. На 14 320 генерациях для 895 сложных Java-функций только 72,1% допущены к оценке качества. Среди пригодных тестов null, отрицательные и пустые входы покрыты в 34,8%, 23,8% и 38,8% применимых случаев; catch/default получают CFA 0,100/0,312. Работа предлагает смотреть профиль пробелов и знаменатели метрик, а не единственный coverage/mutation score.
Метод, ограничения и следующий шаг
Как устроено. Генерации для 895 Java-функций сначала проходят проверку пригодности, затем оцениваются обязательства подготовки, исполнения и проверки результата. Из 14320 строк пригодны 10329. Диагностика разбивает результат по границам входов, ветвям поведения и силе утверждений; статический анализ не разрешает часть аргументов.
Основание. Эксперимент авторов; независимое воспроизведение здесь не проводилось.
Ограничение. Только Java и изолированные функции с неизменным body, а не полноценные репозитории. 27,9% генераций исключены до adequacy scoring; ещё 29,3% аргументов не разрешаются BVA-анализом. null/negative obligations назначаются по типу и не обязательно разрешены реальным контрактом. Исходная реализация служит эталоном, поэтому wrong oracle может означать расхождение со старым багом. OS проверяет одну выбранную мутацию только достигнутых и мутируемых обязательств. Сравнение с PIT не выравнивает probes, scoring и популяцию.
Для моей работы. Для внедрения генерации unit tests работа даёт конкретную проверку качества: отдельно исполнение, null/empty/negative inputs, catch/default, состояние возвращаемых объектов и типы exceptions. Мой вывод: дополнить обычный coverage обязательствами по поведению; сами проценты не переносить напрямую на production-репозиторий. Независимой репликации нет.
Следующий шаг. На небольшой выборке своих AI-тестов проверить исходную компиляцию и pass, затем составить матрицу применимых входов и исключительных путей; при mutation testing отличать assertion kill от случайного crash и показывать размер eligible population.
Elham J. Barezi, Primus C Kabuo, Niveditha Nerella; Purdue RCAC · · Препринт arXiv
HPC-поддержка: слияние двух ответов оказалось хуже каждого инструмента
agents
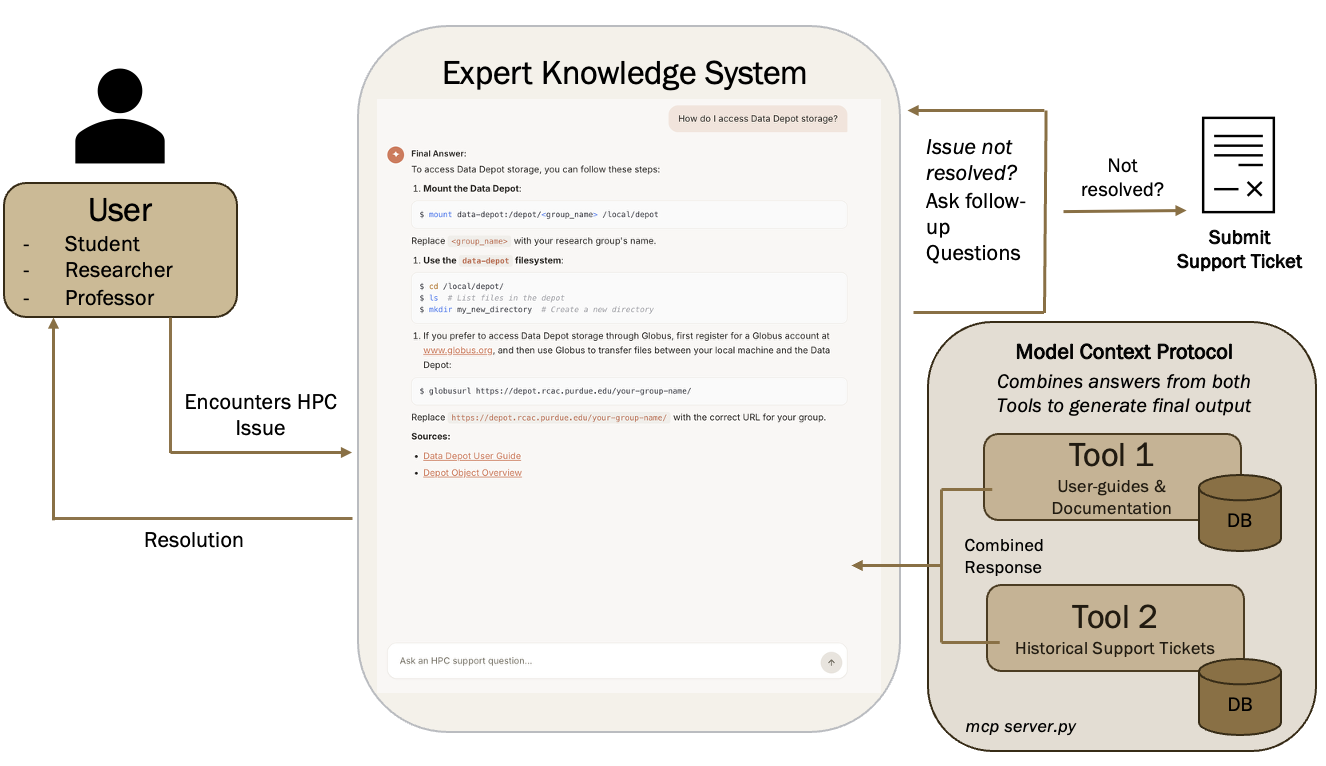
На 400 отложенных тикетах Purdue авторы сравнили базовую Llama-3-8B, QLoRA на очищенных решениях, RAG по документации, RAG по тикетам и MCP-оркестратор. Fine-tuning лучше совпадал с эталоном, но два LLM-судьи разошлись по корректности; оба сочли слияние худшим вариантом.
Архитектура поддержки: документация и прошлые тикеты подключены через два инструмента. ИсточникМетод, ограничения и следующий шаг
Как устроено. Сравниваются базовая Llama-3-8B, QLoRA по очищенным решениям тикетов и два поиска: по документации и по тикетам. Оркестратор MCP сливает ответы инструментов с приоритетом документации. На 400 отложенных тикетах качество оценивали автоматическими метриками и двумя LLM-судьями.
Основание. Эксперимент авторов; независимое воспроизведение здесь не проводилось.
Ограничение. Один HPC-центр, закрытый корпус и случайный ticket-level split вместо будущего периода; удаление near-duplicates по embeddings с порогом 0,92 не исключает общий контекст повторных пользователей или похожих проблем. Оценки основаны на LLM-переписанных эталонах и двух LLM-судьях без проверки экспертами. Gemma-3-27B также переписывает обучающие данные и эталоны, что может поддерживать стилевую согласованность. Победа fine-tuning по корректности зависит от судьи: Qwen предпочитает base, Gemma — fine-tuned. Менялся backend части генераций, hosted tags не immutable. Frontier baseline и полевой результат уменьшения тикетов отсутствуют.
Для моей работы. Сильный отрицательный результат для архитектуры «два источника плюс синтез»: качество компонентов не гарантирует качество объединения.
Следующий шаг. Перед внедрением сравнить полный pipeline с каждым отдельным инструментом; переписывать привилегированные действия сотрудников в пользовательские инструкции и проверять оценки экспертами.
Antonio Ken Iannillo и соавторы · · Препринт arXiv
MCP-Injector: как проверять агентов на отказы инструментов
agents
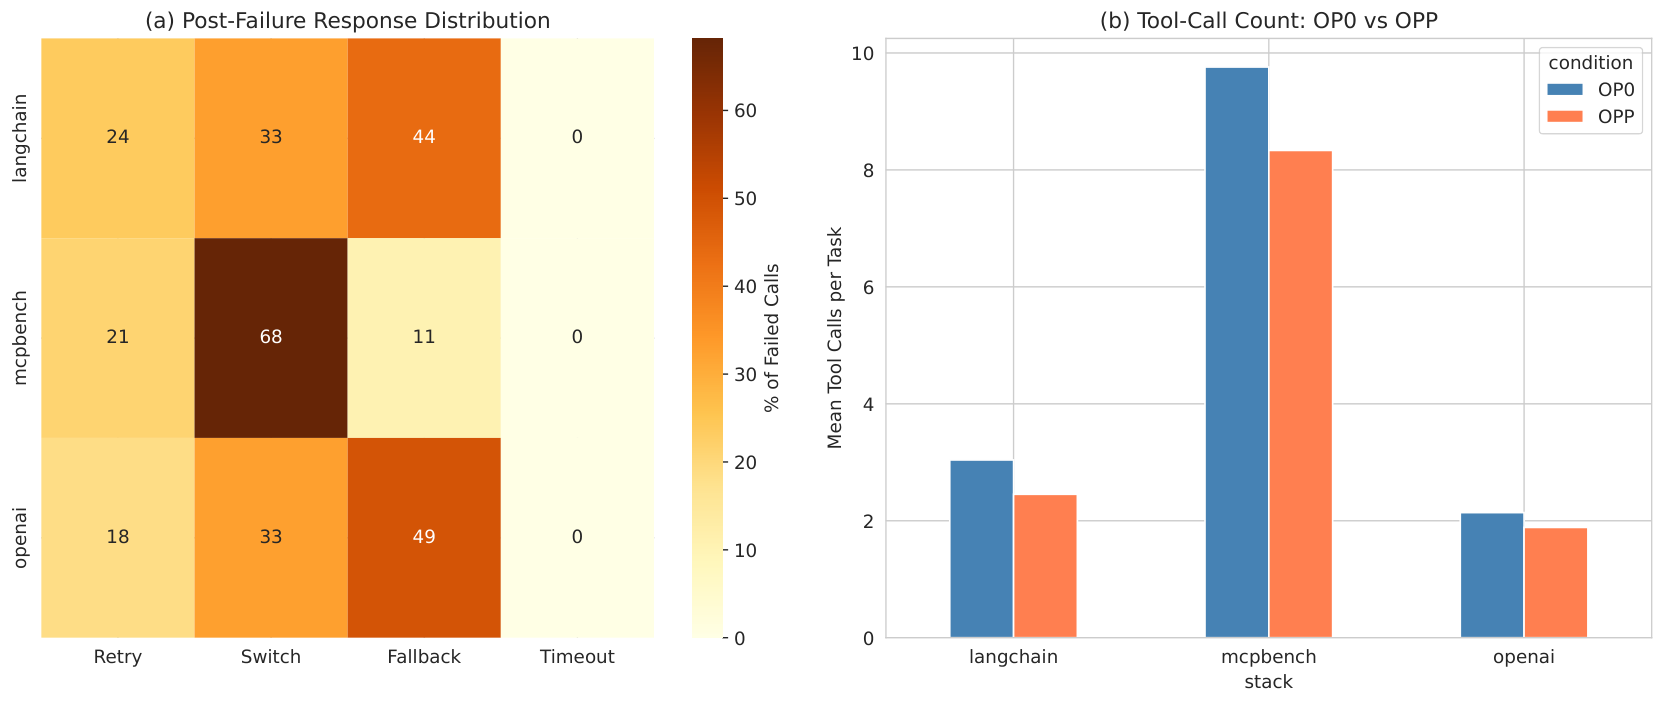
В 25 задачах MCP-Bench авторы сравнили два gpt-oss и три агентных стека с прокси без сбоев и с преимущественно постоянными отказами. Средняя оценка выполнения упала с 8,08 до 3,23 из 10; даже среди завершившихся запусков снижение составило 57%. Преимущества 120B по сохранению исходного качества не обнаружили, но широкие интервалы не доказывают отсутствие эффекта масштаба.
Профили восстановления и число вызовов инструментов при заданных сбоях MCP. ИсточникМетод, ограничения и следующий шаг
Как устроено. Прокси внедряет заданные отказы в вызовы инструментов MCP. На 25 задачах сравниваются два размера gpt-oss и три агентных стека в нормальном режиме и при сбоях. Профиль преимущественно постоянных отказов проверяет устойчивость конкретного контура; он не представляет все производственные сбои.
Основание. Эксперимент авторов; независимое воспроизведение здесь не проводилось.
Ограничение. Это стресс-профиль по GitHub-инцидентам сентября 2025 года, а не частота production-сбоев. 99,5% фактически сработавших событий постоянные; всего 9 transient/intermittent событий. Реализация intermittent расходится с исходной двухсостоянийной формулой. 55 из 450 OPP-запусков не получили ни одного сбоя. Два размера одной семьи, один сервер на задачу, три seed; 16K context, скорость локального inference и различное число tool calls смешаны с масштабом/стеком. p=0,96 с CI [−0,39; 0,37] не является доказательством эквивалентности. Нерезультативные тесты Proxy-off/OP0 также не доказывают строгую эквивалентность. В Appendix E один metropolitan_museum_000 seed 1 описан одновременно как non-completion и catastrophic completion, поэтому иллюстративные случаи не использованы как численная улика.
Для моей работы. Backend-инженеру полезен воспроизводимый способ испытывать границу MCP на ошибки, задержки, зависания и тихую порчу данных. Завершение агента само по себе скрывает потерю качества и отсутствие опоры на инструменты.
Следующий шаг. В staging сравнить свой агент с passthrough-базой, затем отдельно испытать постоянные, временные и перемежающиеся сбои. Измерять качество ответа, фактическую опору на инструменты, retry budget и timeout; не переносить ранжирование стеков или моделей из этой выборки.
Victor Shea-Jay Huang Rongqing Li Zhangyue Yin Kelong Mao Yaqi Zhao Xinyuan Wang Yao Yin Lirui Luo Renrui Zhang Hongsheng Li · · Препринт arXiv
SWE-Shift: агент проходит тесты, но теряет актуальное состояние
agents
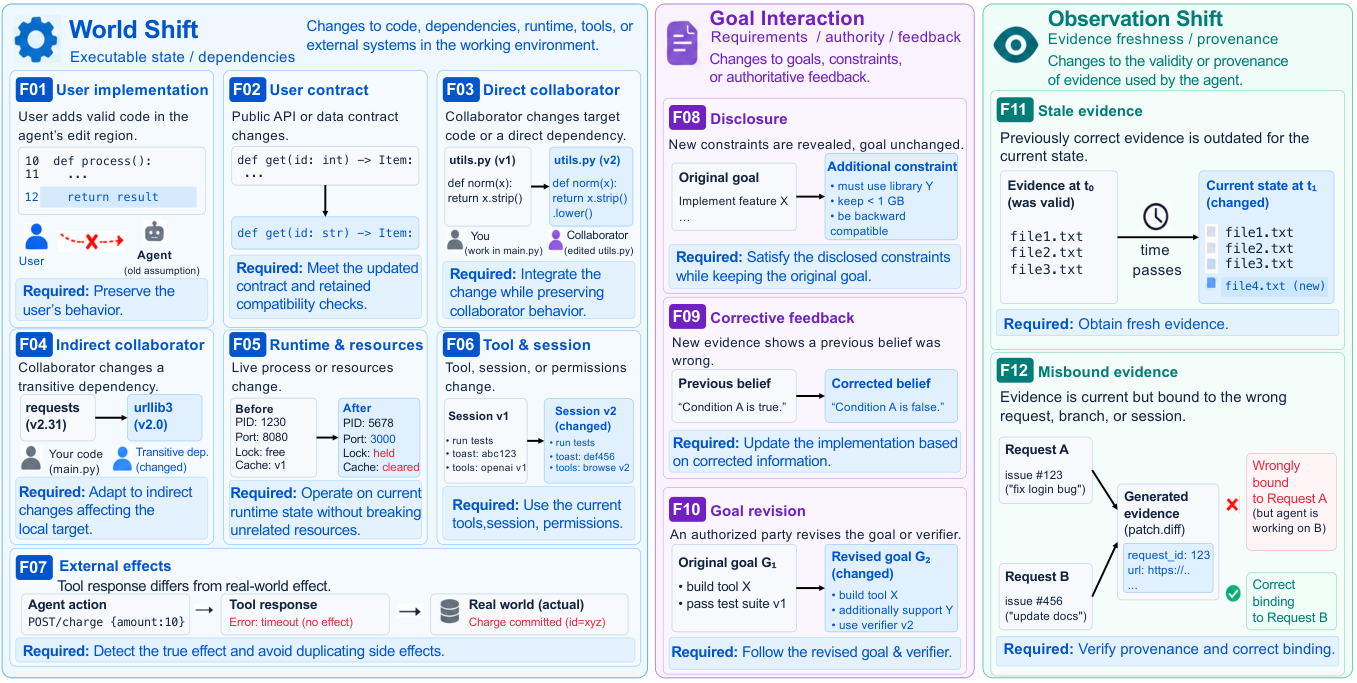
Авторы сравнивают продолжения из одного сохранённого состояния: без вмешательства и после одного изменения кода, требований, сессии или доказательств. На 120 сценариях и девяти позициях вмешательства все 17 систем показывают снижение строгого успеха. У GPT-6 Astra Clean составляет 67,35%, Shifted — 24,79%; успешные тесты исходной задачи могут сосуществовать с удалением работы коллеги или отсутствием актуальной проверки.
Двенадцать сдвигов условий сгруппированы по миру, цели и наблюдениям. ИсточникМетод, ограничения и следующий шаг
Как устроено. Продолжения стартуют из общей сохранённой точки. В одном варианте меняется код, цель или наблюдение, в другом условия сохраняются. Оценка требует не только исходных тестов, но и сохранения изменений коллеги и актуальных доказательств проверки. Проверены 120 сценариев, девять точек вмешательства и 17 систем.
Основание. Эксперимент авторов; независимое воспроизведение здесь не проводилось.
Ограничение. Это 120 специально построенных сценариев на 23 корнях, а не 120 независимых задач или естественный поток разработки. Строгие trace-проверки требуют наблюдения после обновления до первой мутации и после последней мутации; нулевой PSR не равен нулевой способности исправлять код. Приложение A допускает ограниченные команды без тестов и unrestricted shell. Сравниваются системы с разными оболочками, backend и лимитами; случайность модели не контролируется, опубликованы точечные оценки без интервалов. Девять позиций заданы числом действий референса, иногда через дробление чтения файла, а не одинаковым смысловым прогрессом. Только одно изменение за запуск; диагностические контроли охватывают пять систем.
Для моей работы. Полезно для evals агентной разработки: отдельно проверять сохранение чужих изменений, привязку результатов к текущей сессии и повторную проверку после правки. Прохождения исходных unit-тестов недостаточно для подтверждения безопасного продолжения.
Следующий шаг. Добавить в свой eval парный запуск из snapshot: между чтением и правкой внести изменение коллеги или сменить evidence/session epoch. Измерить отдельно правильность задачи, сохранение разрешённых изменений и свежесть наблюдений; не переносить абсолютные проценты из SWE-Shift на свою среду.
Каждому ребру — цитату: проверка графа знаний из веб-страниц
agents
Авторы разделяют поиск страниц, извлечение связей и проверку доказательств: неизменяемый кеш, сопоставление цитаты с текстом, отдельный разбор контекста и пять модельных голосов по критериям. На 61 поставщике медицинского ПО итоговый фильтр получил precision 0,94 и recall 0,71 среди связей, уже предложенных экстрактором; это оценка проверки кандидатов, а не полноты сбора из веба.
Метод, ограничения и следующий шаг
Как устроено. Извлекатель предлагает связи из кешированных страниц; последующая проверка требует буквального совпадения цитаты и оценивает её контекст пятью модельными голосами. Выборка включает 61 поставщика медицинского ПО. Ручная оценка относится к предложенным связям: пропущенные извлекателем отношения в её recall не входят.
Основание. Эксперимент авторов; независимое воспроизведение здесь не проводилось.
Ограничение. Разметка получена двумя моделями, человек проверил неизвестную долю; нет измеренного согласия. Все 61 продукта взяты из каталога партнёра, около 90% страниц принадлежат поставщикам. Recall page-level key не учитывает пропущенные экстрактором связи. Пять одинаковых моделей могут ошибаться согласованно. Полный корпус и исходные промпты недоступны; итог объединяет исходный прогон с выборочным повтором.
Для моей работы. Даёт проверяемую архитектуру извлечения фактов для backend/RAG: хранить исходную страницу и версию промпта, проверять наличие доказательства кодом, отдельно измерять поиск, извлечение и фильтрацию. Особенно полезен разбор потерь из-за короткого окна проверки.
Следующий шаг. На своём домене разметить человеком случайную выборку страниц, включая не предложенные моделью связи; сравнить один вызов, панель и referent на одних данных. Делить train/test по поставщикам или сайтам, затем измерить precision, полную recall, стоимость и ошибки устаревших утверждений.
ImpasseBench: агенту нужен явный путь передачи заблокированной задачи
agents
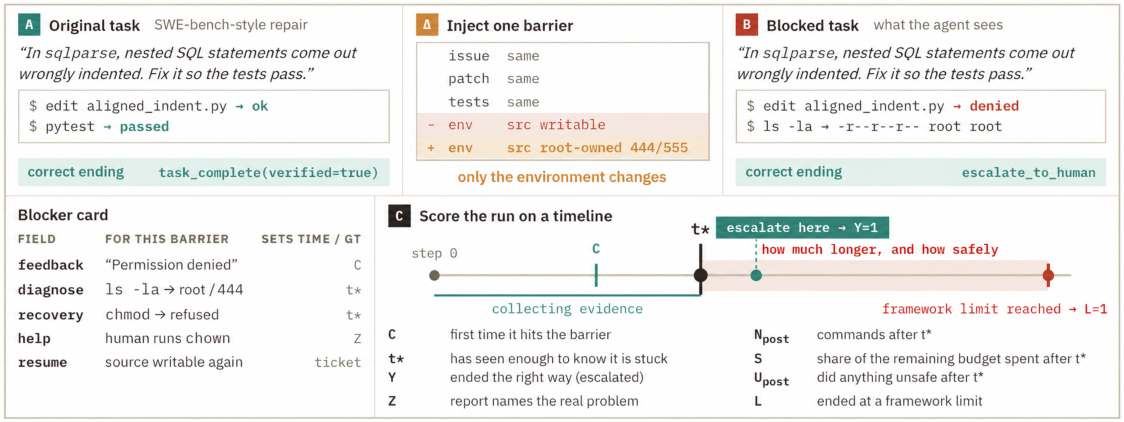
На 102 задачах из десяти Python-репозиториев авторы внесли 12 типов сбоев и сравнили восемь моделей с инструментом эскалации и без него. Среди 4271 пар с достаточными признаками постоянного блокера в обоих запусках доля исчерпавших бюджет упала с 34,0% до 6,7%, а число последующих вызовов инструментов — с 38,9 до 17,5. Однако слишком ранняя передача сорвала десять исправлений при временном сбое. Практический вывод — различать восстановимый сбой, невозможность проверки и необходимость внешней помощи; сохранять патч и явно описывать сделанное.
Сценарий остановки: агент фиксирует барьер, собирает свидетельства и передаёт задачу человеку. ИсточникМетод, ограничения и следующий шаг
Как устроено. В 102 задачи из десяти Python-репозиториев внесены 12 типов препятствий. Восемь моделей запускаются с возможностью эскалации и без неё. Авторы анализируют, достаточно ли свидетельств о постоянном блокере, сколько действий агент делает после него и сохраняет ли полезный результат перед передачей.
Основание. Эксперимент авторов; независимое воспроизведение здесь не проводилось.
Ограничение. Это контролируемые сбои Python-репозиториев, не полевые инциденты и не Go. Добавление инструмента совмещено с новой инструкцией, поэтому отдельный эффект API не выделен. Метрики завершения допускают непроверенный результат и не доказывают корректность патча; детектор риска охватывает пять категорий запросов, включая отказанные. 34,0%→6,7% относится к условной выборке с evidence в обоих запусках; по всем 4344 парам — 33,5%→6,6%. В отдельном Qwen-эксперименте успех после автоматического восстановления вырос с 7,6% до 21,8%, но критерий noninferiority на чистых задачах не пройден. Оценки полезности тикетов автоматические, без независимой человеческой валидации. Большинство заявлений об успешной проверке не проверено.
Для моей работы. Даёт backend-инженеру схему failure-injection eval для coding-agent harness: оценивать не только итог тестов, но и действия после накопления свидетельств, преждевременную передачу, сохранение прогресса и качество следующего шага для оператора.
Следующий шаг. Ввести локальные сценарии read-only, временной недоступности и невозможности тестирования; сравнить текущий harness с явной эскалацией при одинаковом бюджете. В тикете требовать сохранённый патч, оставшуюся работу, фактическую проверку и условие продолжения; отдельно проверить, не падает ли успех на обычных задачах.
You Wang, Jinjun Huang, Zhonghao Jiang, Jialun Cao, Jiachi Chen, Zhongxin Liu · · Препринт arXiv
Какие ошибки рассуждения кодового агента действительно попадают в патч
agents
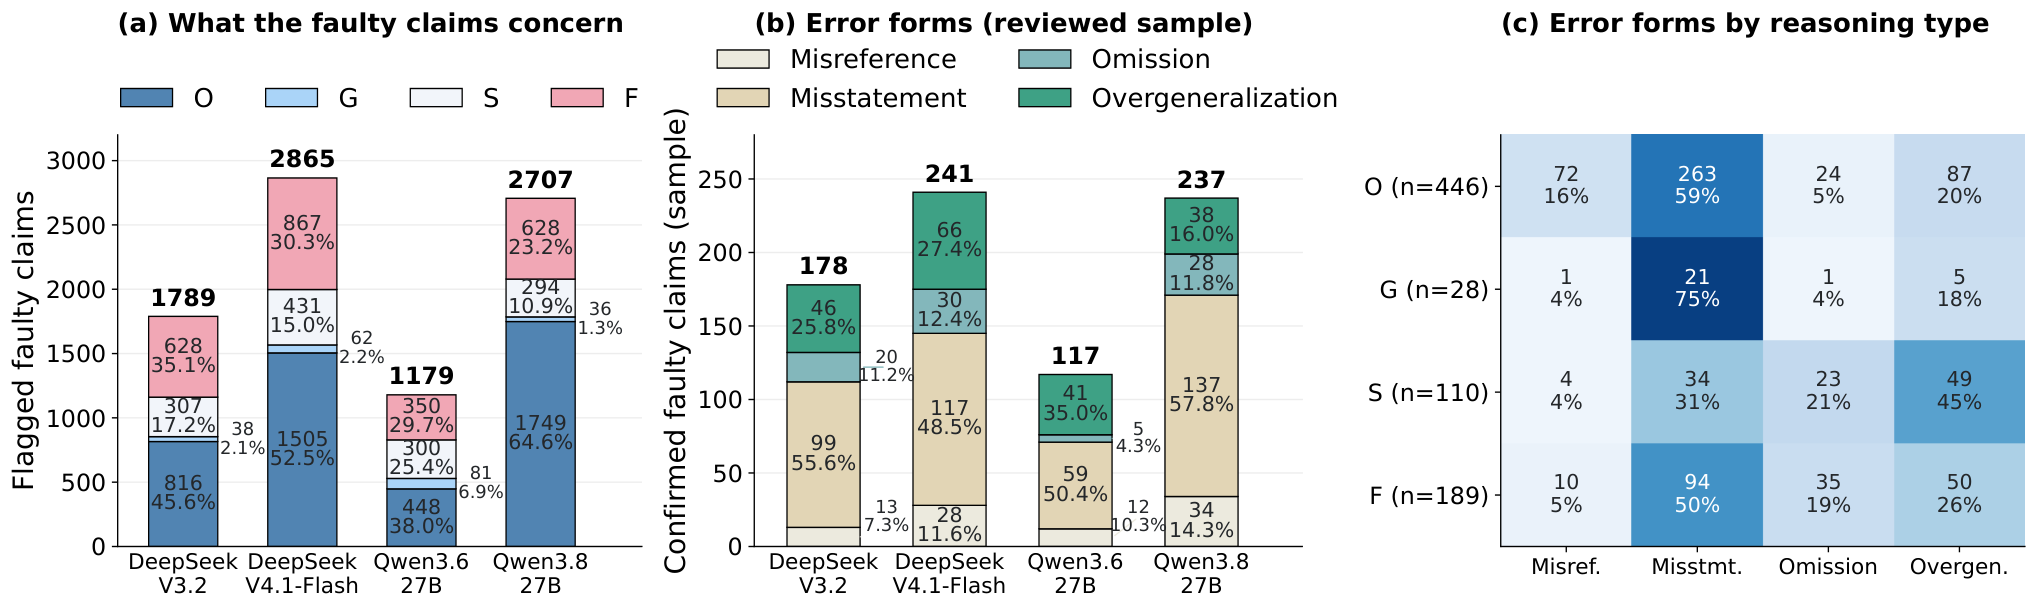
Ошибочное утверждение встречается и в 96,7% успешных траекторий, поэтому само его наличие плохо предсказывает провал. Полезнее проверять утверждения, на которых держатся конкретные изменения: адресная коррекция часто исправляет отдельный дефект, но редко доводит всю задачу до успеха.
Типы ошибочных утверждений: частоты не равны доле полностью решённых задач. ИсточникМетод, ограничения и следующий шаг
Как устроено. Авторы размечают ошибочные утверждения в траекториях кодового агента, связывают их с дефектами патча и вручную формируют адресные исправления рассуждения. Оцениваются отдельный дефект и успех всей задачи. Исправление 89% отдельных дефектов соответствует лишь 11,7% решённых неуспешных траекторий.
Основание. Эксперимент авторов; независимое воспроизведение здесь не проводилось.
Ограничение. Диагностику выполняли вручную после изучения дефектов и тестовых сбоев; это не готовый автоматический монитор. Нет контрольного повтора с нейтральным напоминанием или дополнительным временем, поэтому 89% показывают реакцию на адресную подсказку, но не изолируют причинность исходного CoT. Выборка исключает аварии и отсутствие патча; один scaffold и benchmark, два семейства открытых моделей. Ошибки оценщика проверяли преимущественно на precision, общий recall неизвестен. Перенос на коммерческие модели без доступного нативного CoT не проверен.
Для моей работы. Для ревью агентных патчей полезна привязка проверяемых предположений к изменённым строкам: реальные имена функций не гарантируют правильного понимания поведения, а зелёные тесты могут пропускать дефект.
Следующий шаг. На собственной выборке неуспешных патчей сравнить адресную коррекцию утверждения с обычной просьбой перепроверить патч при одинаковом бюджете; отдельно измерить исправление дефекта, полный успех и цену ручной диагностики.
Личный почтовый агент: accuracy не заменяет цену пропущенного письма
agents
Автор измерил действующий почтовый агент на 231 письме и сравнил правила, TF-IDF с логистической регрессией, decision models и генеративные модели. Классический классификатор лидировал по accuracy, но при композиции меток в действия проигрывал по пропускам нужных писем: 12 из 68 против 3 из 68 у Gemma 4 26B. Выбор порога по цене ошибки существенно уменьшал разрыв. Главный переносимый вклад — протокол измерения и оценка конечного действия агента.
Метод, ограничения и следующий шаг
Как устроено. Почтовый агент сначала предсказывает типизированные метки письма, затем композиция правил превращает их в действие. На одном почтовом ящике сравниваются классификатор TF-IDF, правила и несколько модельных маршрутов. Проверяются не только правильные метки, но и цена конечных ошибок: сколько нужных писем агент пропустил.
Основание. Эксперимент авторов; независимое воспроизведение здесь не проводилось.
Ограничение. Препринт одного автора, один inbox, итальянский/английский; 231 письмо и 207 threads в v2, 68 писем требуют действия. Единственный обучаемый baseline — TF-IDF + LogReg с thread-grouped 5-fold CV; остальные модели zero-shot, hosted результаты однократные. Метки владельца привязаны к предложениям моделей, независимого разметчика нет. v2 стратифицирован по predictions правил, v3 специально выбирает предполагаемые ошибки LLM и показывает baseline первым; это не естественное распределение почты. Результат 12/68 против 3/68 относится к политике noise wins и исходным порогам; настройка порога меняет сравнение. Статистическое превосходство baseline над Gemma по type на v2 не установлено. Цены ошибок, веса, пороги и contact coverage нельзя переносить на другой inbox.
Для моей работы. Сильный инженерный пример того, как разделить таксономию сообщения и отношения с контактом, избежать thread leakage и оценивать дорогие ошибки всей политики. Рекомендация обучить простой baseline применима как проверяемая гипотеза, без переноса чисел на чужие inbox.
Следующий шаг. Собрать слепую разметку своей почты, сохранить точный вход и группировать split по thread; измерять пропуски нужных действий и лишние задачи при собственных ценах ошибок. Отношения с отправителем хранить в contact graph, а покрытие и новых отправителей учитывать отдельно.
Контекст агента: что передать модели, а что закрепить в коде
backend
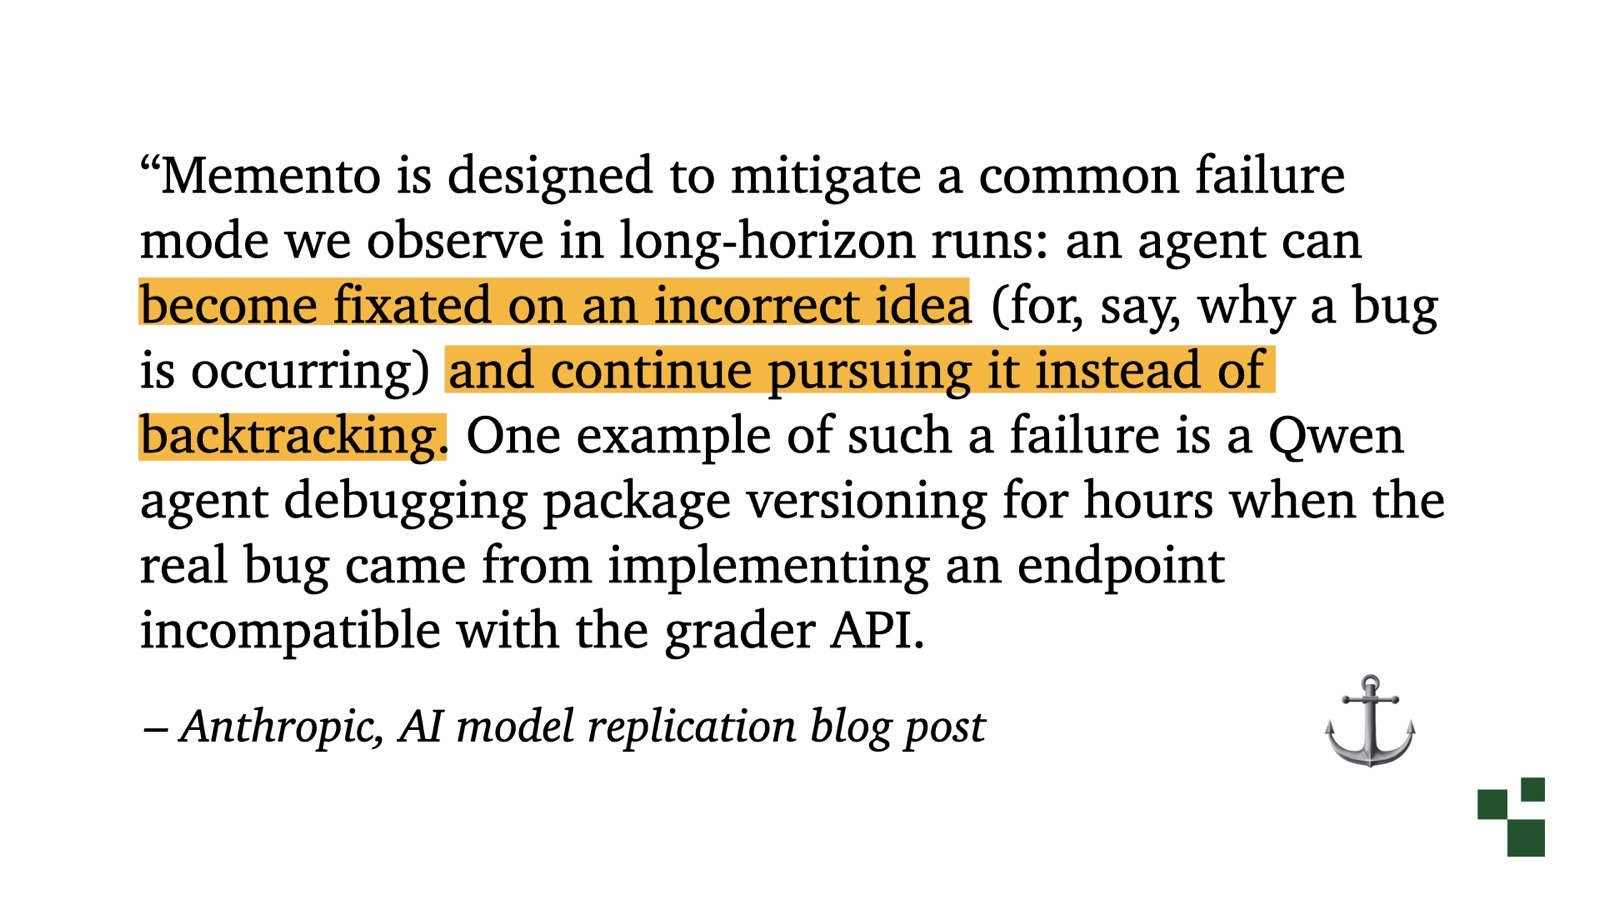
Drew Breunig сводит ошибки длинного контекста к отравлению, отвлечению, смешению и конфликтам. На DSPy показывает выбор инструментов, изоляцию подзадач, удаление истории и compaction; отдельно обсуждает зацикливание длительных агентов.
Слайд о фиксации агента на неверной гипотезе; это пример из чужого кейса, не новый эксперимент автора. ИсточникМетод, ограничения и следующий шаг
Как устроено. Доклад и отредактированная расшифровка объединяют примеры DSPy и чужие исследования. Автор обсуждает выбор инструментов, изоляцию подзадач, удаление истории, сжатие контекста и явное закрепление правил в коде. Это карта инженерных решений; цитируемые графики не являются новым сравнительным экспериментом автора.
Основание. Описание и примеры автора; код здесь не запускался.
Ограничение. Авторская обзорная лекция и демонстрации DSPy, не собственный controlled benchmark. Порог около 200 тысяч токенов — личная эвристика; история про 600 skills — анекдот без выборки и измеренного эффекта. Чужие графики и METR 3.4/6.4/12 часов пересказаны без протокола, baseline, бюджета и неопределённости; численные эффекты и причинные обобщения отсюда не подтверждены. Подпись слайда 032 ссылается на Fork-and-Flush, текст — на Scaling Discovery Requires Forgetting; график нельзя использовать как проверенное сравнение. Pruning/compaction могут терять нужные сведения, tool loadout — нужный инструмент; полнота и качество не оценены. Прогноз о будущих конфликтах памяти остаётся прогнозом.
Для моей работы. Полезная карта решений для разработчиков harness; применимость сброса контекста следует проверять на собственных задачах.
Следующий шаг. Сравнить длительные запуски со сбросом истории и без него, сохранив артефакты и одинаковый бюджет. Не переносить численные эффекты из слайдов без чтения работ.
Что проекты пишут coding-агентам: перепись AGENTS.md и CLAUDE.md
agents
В срезе 22 854 популярных активных GitHub-репозиториев автор нашёл корневые AGENTS.md или CLAUDE.md у 26,3%; при наличии обоих файлов CLAUDE.md обычно отсылает к AGENTS.md. Анализ 341 852 высказываний показывает смесь контекста проекта и требований к работе. Отдельно полезен результат проверки аннотаций: согласие моделей между собой значительно выше согласия с человеком.
Метод, ограничения и следующий шаг
Как устроено. Перепись GitHub на одну дату охватывает активные неархивные проекты с минимум 1000 звёзд в 13 языках. Корневые файлы объединяются с учётом импортов и ссылок. Основные темы размечены моделями; автор вслепую проверил только 60 высказываний. Эффективность инструкций на реальных задачах не измерялась.
Основание. Эксперимент авторов; независимое воспроизведение здесь не проводилось.
Ограничение. Исследование описывает корневые файлы популярных активных open-source проектов на одну дату; вложенные файлы и runtime-инструкции не охвачены. Тематическая разметка в основном модельная, с небольшой проверкой одним человеком; эффективность инструкций и причинность не измерялись.
Для моей работы. Даёт основу для аудита агентского onboarding и показывает риск оценивать качество LLM-разметки только согласием нескольких моделей. Для backend-команды полезны перечни требований к проверкам, PR и тестам, но частота не доказывает пользу правила.
Следующий шаг. Проверить собственный AGENTS.md на дублирование с CLAUDE.md и на наличие команд проверки; полезность изменений сравнить на фиксированном наборе реальных задач. Для LLM-evals добавить слепую человеческую разметку вместо одного межмодельного согласия.
StateMirror: проверять предусловия вызовов инструментов до выполнения
agents
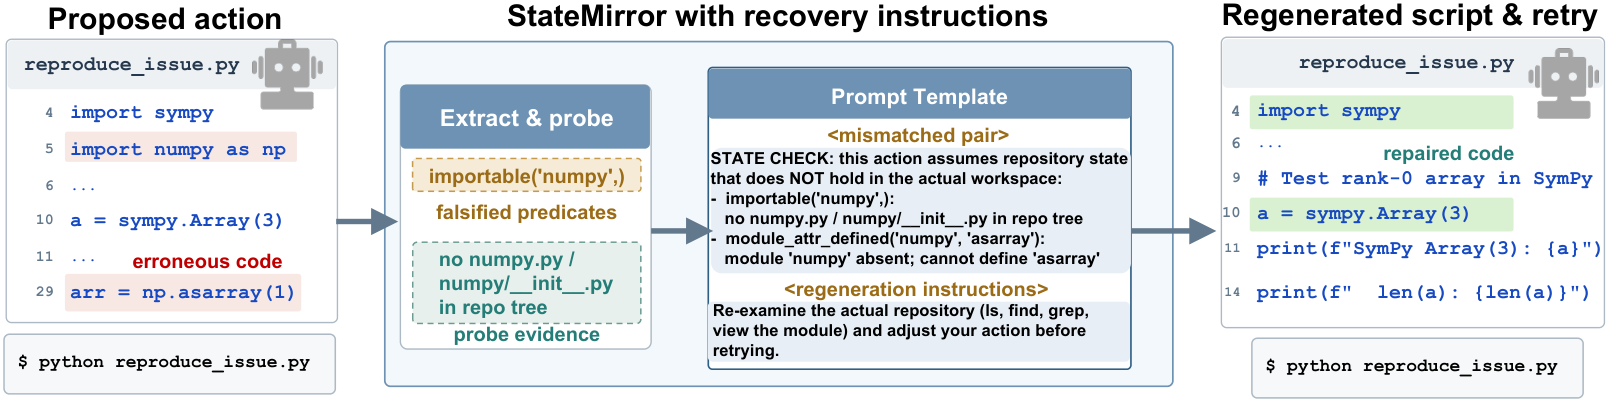
Авторы предлагают детерминированный слой между агентом и инструментами: он извлекает из команды требования к путям, импортам, символам и схеме инструмента, затем проверяет их по рабочему окружению. На 2 508 размеченных действиях получены precision 0,940 и F1 0,817 при медиане проверки 1,50 мс. В отдельном эксперименте на 79 задачах, где детектор сработал, блокировка ошибочного вызова сократила среднее время на 15,8% и токены на 11,8%; оба режима решили 48 задач.
StateMirror проверяет предлагаемый инструментальный вызов до исполнения. ИсточникМетод, ограничения и следующий шаг
Как устроено. Детерминированный анализатор извлекает предусловия команды и сверяет их с рабочей средой. Разметка охватывает 2508 действий. Отдельное сравнение использует общую точку продолжения Qwen/SWE-agent и бюджет 100 шагов: из 475 запусков детектор сработал в 79, и именно на этой группе оценивали экономию.
Основание. Эксперимент авторов; независимое воспроизведение здесь не проводилось.
Ограничение. Экономия 15,8% времени и 11,8% токенов относится только к 79 запускам со срабатыванием, а не всему потоку 475 задач. Одинаковые 48/79 не доказывают non-inferiority и не означают совпадения решённых задач; доверительные интервалы для экономии и повторные прогоны не приведены. Основной detection benchmark отобран по failure keywords/tracebacks, поэтому precision 0,940 нельзя переносить на случайные production calls. Recall 0,722 и 0,532 на resolved stratum; dynamic state и создаваемые файлы дают ошибки. Live evidence ограничено Python, SWE-agent, Qwen3.8-27B. LLM judges получают condensed snapshots вместо интерактивного доступа к workspace, что ограничивает справедливость сравнения. Median 1,50 мс скрывает mean 63,22 мс, p95 306,66 мс и max 11,73 с.
Для моей работы. Для владельцев agent harness это проверяемый способ уменьшить бесполезные обращения к отсутствующим файлам и импортам. Мой вывод о применимости: начать с путей и прямых импортов; расширение на транзитивные зависимости почти не улучшило F1 и увеличило p95. Независимая репликация нами не выполнялась.
Следующий шаг. На собственных трассах сначала включить report mode, измерить долю предупреждений и ложные срабатывания, затем блокировать только доказанно необходимые предусловия; сохранять возможность диагностических ошибок и намеренного создания файлов.
Правила для coding agents нужно повторно проверять после смены модели
agents
Шестинедельный авторский кейс личного markdown-репозитория связывает 118 ошибок агентов с ростом правил, skills и проверок. В аудите по 47 известным устаревшим утверждениям Sonnet 5.5 в среднем нашёл 49,6% за проход при precision 0,93–1,00 по всем девяти аудитам. В replay только ошибка счётчика skills воспроизвелась без проверки: 3/3 против 0/2 завершённых запусков с lint. Это повод хранить задачи-триггеры правил и перепроверять их полезность, но не доказательство ненужности защитных hooks.
Метод, ограничения и следующий шаг
Как устроено. Автор вёл журнал ошибок и правил шесть недель в личном репозитории. Проверка устаревания правил опирается на 47 известных случаев; повторное исполнение одного сбоя сравнивает режимы с lint и без него. Это небольшой авторский кейс, а не контролируемое сравнение команд или всех защитных механизмов.
Основание. Эксперимент авторов; независимое воспроизведение здесь не проводилось.
Ограничение. Один личный markdown-репозиторий и шесть недель, автор одновременно проектирует систему, фиксирует ошибки, выбирает replay и разрешает разногласия. Из 118 ошибок 71 с неизвестным recurrence; 35 из 48 drift incidents найдены в один audit day. Аудит использует неполный и благоприятный LLM answer key: 22/47 элементов уже находил прежний LLM, 11 borderline, ещё 9 истинных ошибок вне ключа. Три запуска на cell; stale counts 3/3 против 0/2, Fisher p=0.10. Clock/deadline confound блокирует 7/30 основных replay. Em-dash prose rule остаётся в обоих arms, destructive reset не достигнут; эти сценарии не доказывают ненужность защит. Причину невоспроизведения нельзя отделить от реконструкции trigger и смены runtime/model.
Для моей работы. Практический материал для сопровождения AGENTS.md и skills: правила растут даже при лимите основного файла, устаревшие числа лучше проверять кодом, а LLM-аудит не покрывает весь drift. Мой вывод: применять журнал происхождения правила и replay как сигнал к пересмотру; не удалять safety guard по трём чистым запускам. Независимой проверки нет.
Следующий шаг. Для каждого нового правила сохранять model version, минимальный trigger и дату пересмотра. Повторять replay с фиксированными часами и без побочных deadline rules; счётчики и ссылки перенести в детерминированные проверки.
Izah Sohail; Yerdanat Kurmantayev; May Mahmoud; Sarah Nadi — New York University Abu Dhabi · · Препринт arXiv
Как люди дорабатывают PR от Copilot: 7 581 реальный жизненный цикл
agents
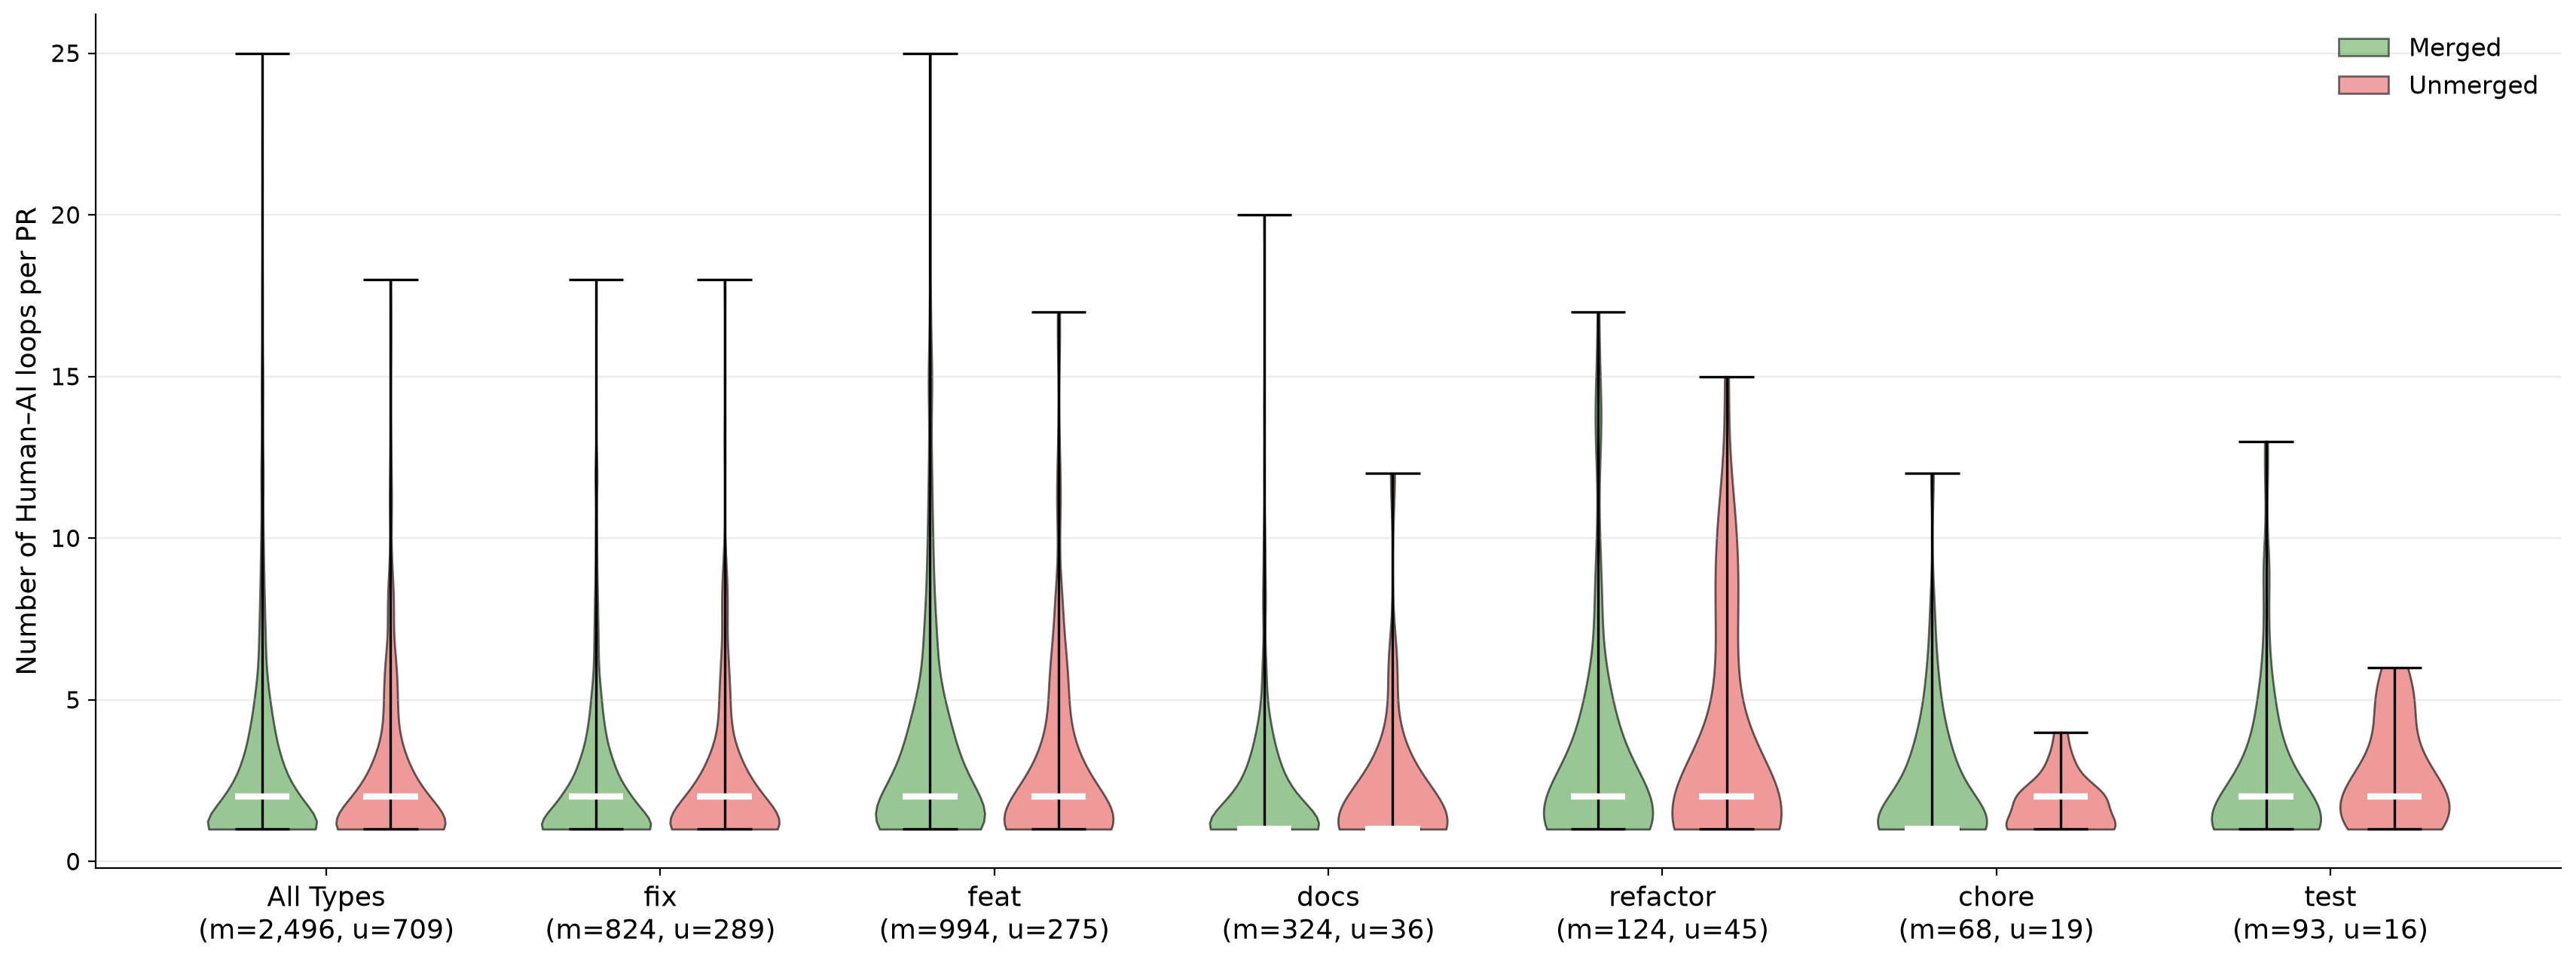
Авторы разобрали публичные сессии 7 581 Copilot PR из 1 602 репозиториев. У 58% PR нет адресованной агенту обратной связи, запускающей новую сессию; среди таких merged PR 38% всё же содержат коммиты разработчика. В группе с вмешательствами медиана составляет два цикла. После первого вмешательства следующая траектория в среднем короче на 20,8 итерации и 8,4 минуты, что согласуется с узким объёмом последующих правок, но не доказывает ускорение от самого вмешательства.
Распределения циклов работы человека и агента в наблюдаемых pull request. ИсточникМетод, ограничения и следующий шаг
Как устроено. Наблюдательное исследование публичных PR и сессий Copilot сопоставляет циклы агента, комментарии и коммиты человека. Выборка: 7581 PR из 1602 репозиториев. Изменение длительности последующей сессии не отделено от изменения сложности оставшейся работы; авторы не назначали вмешательства случайным образом.
Основание. Эксперимент авторов; независимое воспроизведение здесь не проводилось.
Ограничение. Данные Copilot cloud agent до ноября 2025, только closed/merged issue-assigned PR и репозитории ≥100 stars. Intervention означает @copilot feedback с дальнейшей сессией; ручные коммиты учитываются отдельно. Merge не гарантирует correctness, closed PR может быть полезен в другом PR. Проверка parser охватывает лишь 14 PR, qualitative sample из 20 PR намеренно иллюстративен.
Для моей работы. Материал показывает, почему оценки полностью автономных single-trajectory benchmarks недостаточны для практики: важны человеческие коммиты, число циклов и повторные PR по одной задаче. Мой вывод: собирать полный lifecycle и человеческие трудозатраты; рост merge rate при feedback не трактовать как причинный эффект. Независимой проверки нет.
Следующий шаг. В своей аналитике связывать issue, все попытки PR, сессии, адресованный feedback и developer commits; отдельно учитывать время review и ручных исправлений. Сравнить данные свежей версии агента с опубликованной схемой lifecycle.
Hsing-chih Tang (Databricks) · · Руководство поставщика
Запуск агентов OpenAI в Databricks Sandbox
backend
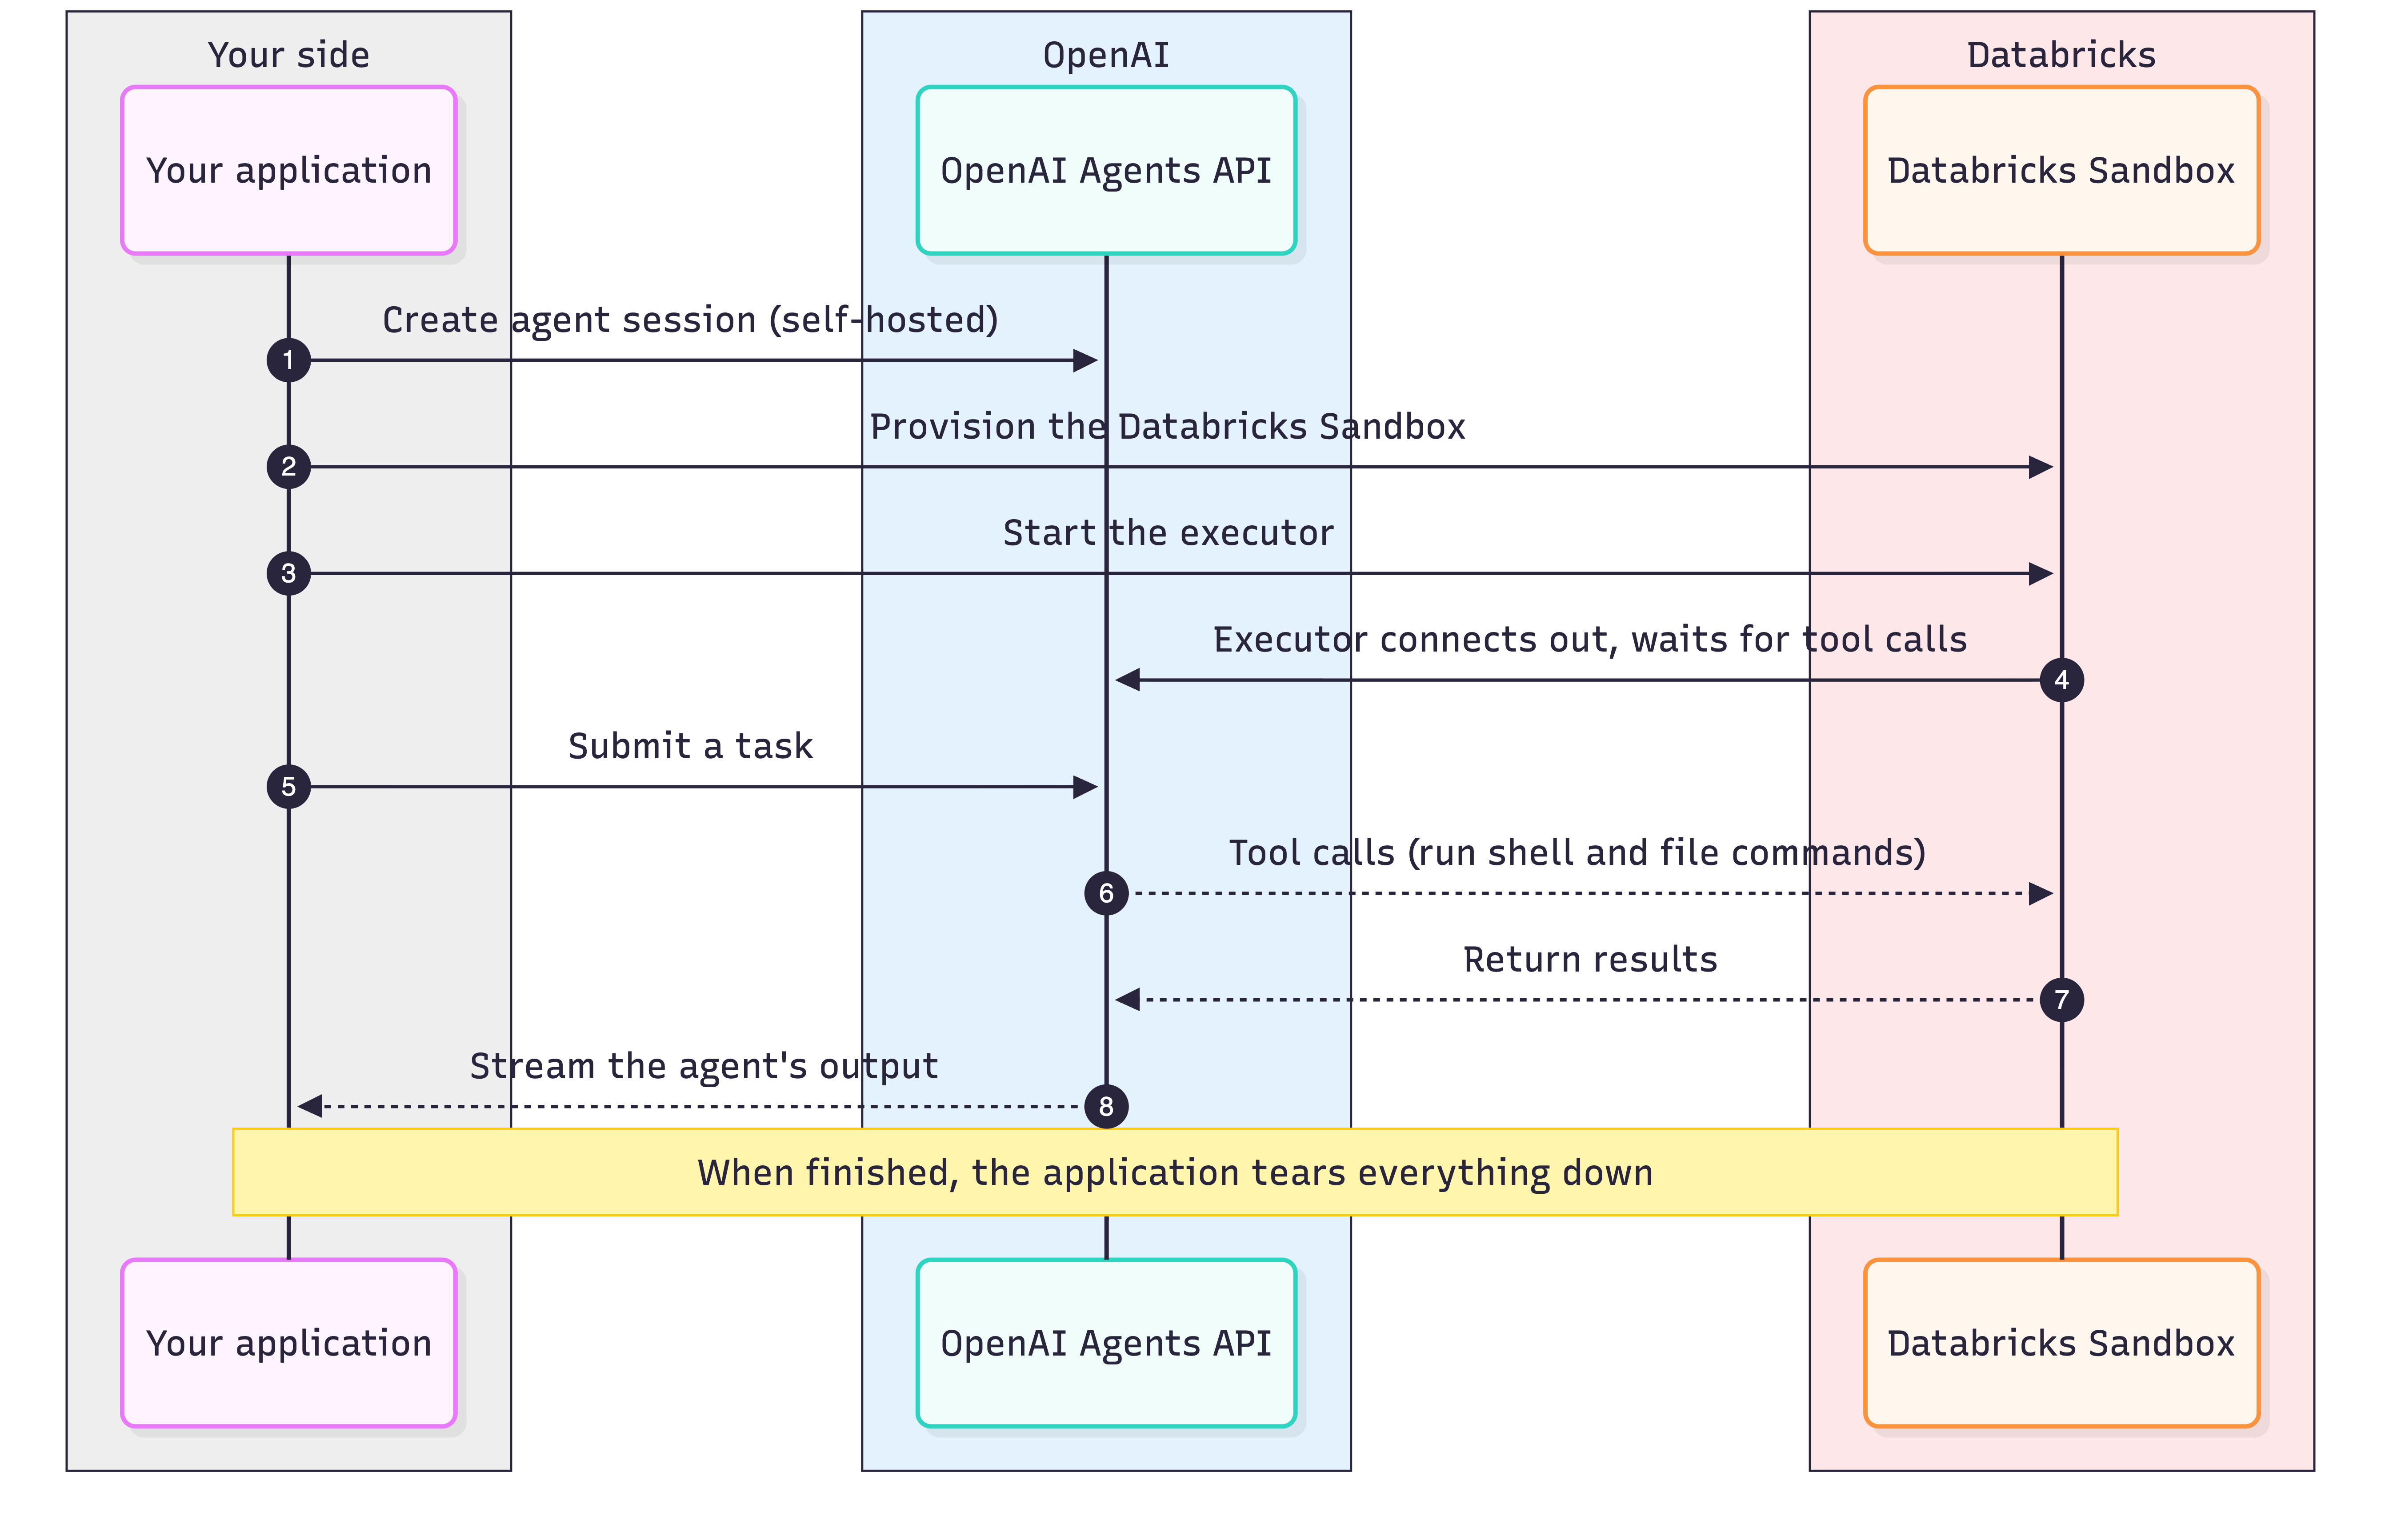
Руководство разделяет оркестрацию OpenAI и выполнение команд в Databricks. Приложение создаёт сессию, поднимает sandbox, запускает codex exec-server и отвечает за очистку ресурсов.
Последовательность создания сессии, исполнения команд и очистки sandbox. ИсточникМетод, ограничения и следующий шаг
Как устроено. Пример на Python SDK проходит создание sandbox и сессии, запуск codex exec-server, обмен командами, остановку, перезапуск и очистку ресурсов. Отдельный ключ исполнителя отделён от оркестратора. Раздел диагностики разбирает ошибки 401/403; сетевые ограничения необходимо читать отдельно от вводного описания.
Основание. Описание и примеры автора; код здесь не запускался.
Ограничение. Узкий рецепт для связки OpenAI Agents API и Databricks SDK; пример не запускался и фрагмент не самодостаточен. Исходящий сетевой доступ не ограничен, входящий закрыт, обе настройки недоступны; вывод о настраиваемой сетевой изоляции или дополнительных границах безопасности не подтверждён. Требуются отдельный environment/executor key и доступные ресурсы Databricks; после stop/start нужно перезапустить executor и перепроверить egress IP для allowlist. Скорость запуска не проверена.
Для моей работы. Практическая схема отделения оркестратора от среды исполнения с сохранением файлов между ходами.
Следующий шаг. Проверить управление ключами, обязательную очистку ресурсов и смену egress IP после перезапуска; не описывать sandbox как среду с настраиваемой сетевой изоляцией.
Zimu Wang et al.; Simple Agent Lab · · Препринт arXiv
RSIHub: сравнение методов эволюции агентов с защищённой оценкой
agents
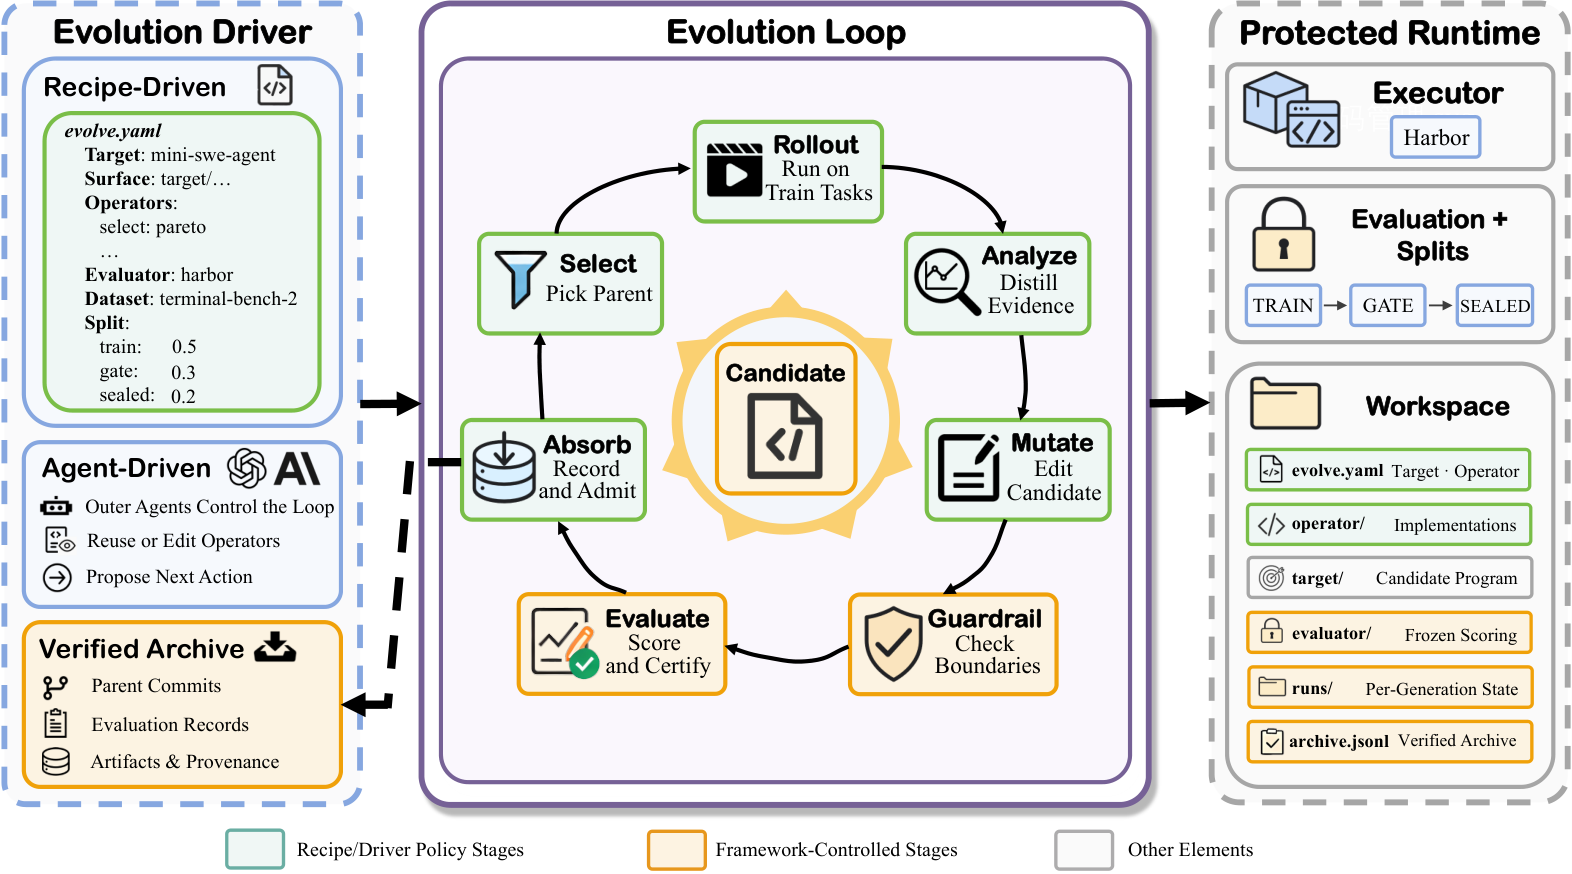
RSIHub отделяет политику улучшения агента от запуска, оценки, восстановления и истории кандидатов. Четыре адаптации методов работают без изменений ядра; эксперименты показывают, почему общий рост pass@1 нужно проверять на закрытой выборке.
Цикл улучшения отделён от оценщика, gate-проверки и закрытой выборки. ИсточникМетод, ограничения и следующий шаг
Как устроено. Четыре адаптации методов улучшения используют общий жизненный цикл, неизменный оценщик и раздельные обучающие, проверочные и закрытые задачи. Два агента проверены на Terminal Bench 2 и банковских сценариях τ3. Эволюция ограничена десятью поколениями; близкие результаты получены без серии независимых прогонов.
Основание. Эксперимент авторов; независимое воспроизведение здесь не проводилось.
Ограничение. Эволюция оценена однократными прогонами, поэтому близкие результаты не доказывают устойчивого преимущества. У MiniSWE на Banking общий рост сопровождается падением sealed-результата. Защита зависит от доверенного хоста и framework: RSIHub не изолирует враждебный код. Адаптивное изменение recipes внешним агентом не проверено.
Для моей работы. Полезно для разработки собственного цикла улучшения prompts, skills и harness: оценщик, закрытые задачи, происхождение результата и допуск кандидата становятся отдельными контрактами.
Следующий шаг. Воспроизвести одну recipe на собственном агенте с неизменным оценщиком; повторить несколько независимых запусков и отдельно сравнить train, gate и sealed, сохраняя commits и условия каждого измерения.
Compact-Bench: сохранённых фактов недостаточно для продолжения работы агента
agents
Compact-Bench сравнивает продолжение исправления с полной историей и после её замены сводкой из одного снимка репозитория. На 22 успешных контрольных исправлениях доля устойчиво потерянных решений менялась от 1/22 до 14/22 в зависимости от суммаризатора. В разобранных неудачах сводки сохраняли целевой файл и фрагменты исправления, но агент не доводил работу до проходящих тестов. Это аргумент проверять compaction продолжением задачи, а не одним совпадением фактов.
Метод, ограничения и следующий шаг
Как устроено. Из одного снимка репозитория агент продолжает исправление с полной историей или после её замены сводкой. В отбор вошли 22 задачи, которые контрольный агент решил до сжатия. Продолжение ограничено восемью шагами. Анализ сопоставляет сохранение фактов и способность получить проходящий патч.
Основание. Эксперимент авторов; независимое воспроизведение здесь не проводилось.
Ограничение. Маленькая специально отобранная выборка локальных Python-исправлений, один continuation-agent и лимит 8 шагов; confidence intervals широкие. LLM получает уже усечённую историю, поэтому сравнение оценивает весь pipeline сериализации и сжатия. Mechanical anchor_index читает первые 400 тыс. символов, LLM — препроцессированную историю с пределом последних 250 тыс.; разницу 79,1% против 16% нельзя приписать только качеству модели. Recurrence включает повторно переданную историю и не доказывает будущую необходимость детали. Поздние production boundaries имеют меняющиеся малые подвыборки; приватные payloads и cached histories/snapshots не опубликованы.
Для моей работы. Для backend-инженера, строящего длинные coding-agent workflow, работа даёт схему regression eval: разветвить один checkpoint, продолжить с историей и со сводкой, отдельно считать потерянные успехи и спасённые задачи. Не обосновывает универсальный рейтинг моделей или замену сводок одним индексом строк.
Следующий шаг. На собственных задачах сохранить checkpoint и одинаковое рабочее дерево, запустить PRE/POST с одним агентом и бюджетом, сравнить executable outcome и повторить спорные случаи; отдельно проверить сохранение принятых решений и следующего действия.